arXiv · 2021 · Preprint
ViR:the Vision Reservoir
Vision Reservoir replaces trainable Transformer attention layers with fixed recurrent reservoirs to classify images efficiently without large-scale pretraining.
The scientific question
Can dynamical reservoirs replace self-attention for parameter-efficient image classification from scratch?
Vision Transformers require heavy computation and memory during large-scale pretraining and often overfit when trained from scratch on smaller datasets.
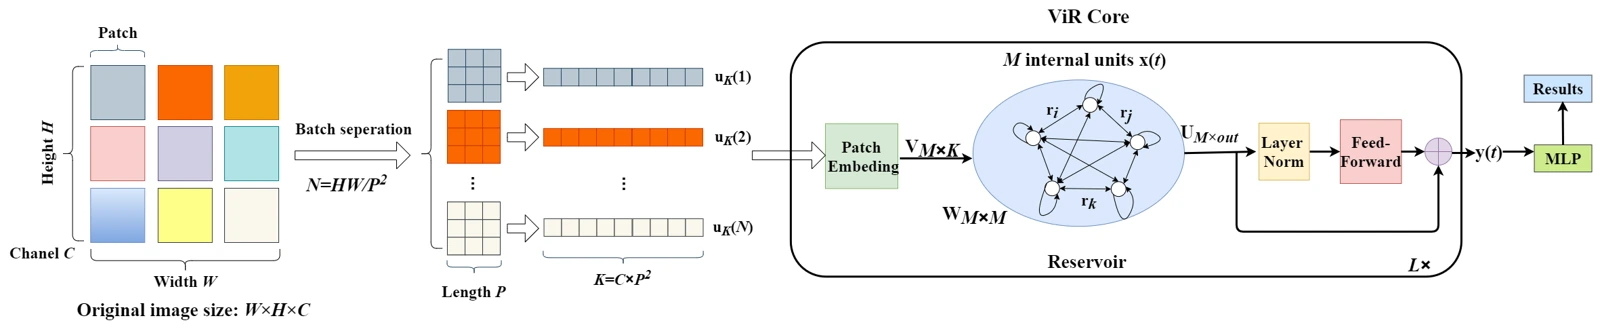
The core idea
Tokenized Deep Vision Reservoir Architecture
Splitting images into fixed-length token sequences, ViR substitutes multi-head self-attention with nearly fully connected recurrent reservoir modules arranged in single- and multi-layer architectures.
What we found
Pretraining-Free Efficiency via Reservoir Dynamics
Across image classification benchmarks without pretraining, ViR outperforms Vision Transformers in both model and computational complexity, requiring 5% to 15% of the parameters and 20% to 40% of the memory footprint, as explained by small-world characteristics, Lyapunov exponents, and memory capacity.
Continue the question
Related reading
- Connectome-to-Function: Conditional Generative Latent Representations for Reservoir ComputingarXiv · 2026
- SFA: A Statistical Physics-Inspired Diffusion Transformer for Efficient and High-Quality Image GenerationarXiv · 2026
Cite this work
Xian Wei, Bin Wang, Mingsong Chen, Ji Yuan, Hai Lan, Jiehuang Shi, Xuan Tang, Bo Jin, Guozhang Chen, Dongping Yang. ViR:the Vision Reservoir. arXiv, 2021. doi:10.48550/arXiv.2112.13545.